Inteligência física · Robótica · Aprendizado autônomo
O robô da Skild AI que aprendeu a jogar futebol contra si mesmo durante 140 anos simulados
2026-09-25 · 8 min de leitura
Por Álvaro AbrilCEO de Geniales.co · Director de KingNews.online
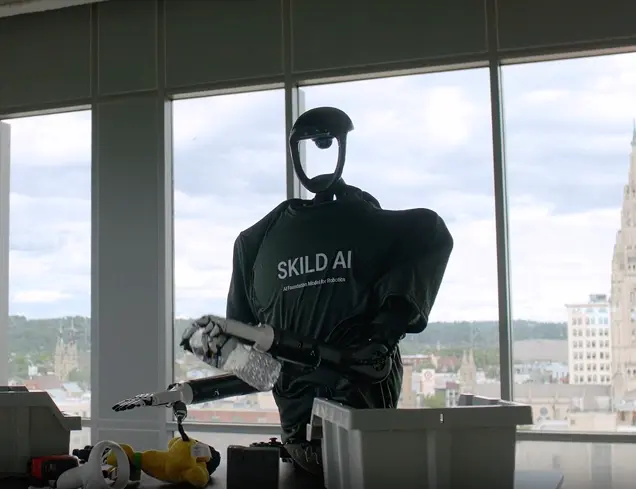
A Skild AI deu a um humanoide apenas uma meta —marcar— e deixou que a competição gerasse o resto. Após milhares de partidas paralelas em simulação, surgiram equilíbrio, velocidade, drible, defesa e jogo coletivo sem programar cada movimento separadamente.
Uma ordem simples abriu um repertório complexo
O objetivo não dizia «drible», «corra» nem «mantenha o equilíbrio». Segundo a Skild AI, o sistema só precisava marcar. A partir desse sinal, um modelo de inteligência física foi enfrentado repetidamente contra versões de si mesmo dentro do NVIDIA Isaac Sim. Cada novo rival obrigava o agente a encontrar respostas melhores, enquanto milhares de partidas podiam ser executadas em paralelo.
A empresa calcula que o processo acumulou o equivalente a mais de 140 anos de futebol simulado em poucas semanas de tempo real. Não foram 140 anos de relógio nem uma corrida contínua de um robô físico: é a soma da experiência produzida simultaneamente por muitos ambientes virtuais sobre infraestrutura de computação.
No início, o agente mal caminhava. Com a competição, surgiram o levantar-se após uma queda, acelerar, aproximar-se da bola, orientá-la, protegê-la e disputar sua posse. Em confrontos com vários agentes, também surgiram passes e coordenação. Essas condutas não receberam uma recompensa individual; revelaram-se úteis porque aumentavam a probabilidade de marcar.
O que significa aprender por autojogo
O self-play — autojogo — transforma o próprio sistema em um gerador de adversários e de dados. Uma cópia tenta superar a outra; a versão aprimorada passa a ser o rival seguinte e o nível de dificuldade aumenta sem depender exclusivamente de demonstrações humanas. A ideia tem antecedentes conhecidos em jogos como Go, StarCraft II e Dota 2, mas transferi-la para um corpo introduz gravidade, inércia, contato, latência e risco de danos.
No futebol, uma política rígida pode resolver uma trajetória prevista, mas se rompe quando mudam a bola, o rival ou a posição inicial. A competição obriga a responder a situações dinâmicas. O valor do teste não está em formar um atacante profissional, mas em mostrar como um objetivo de alto nível pode produzir um conjunto de capacidades motoras reutilizáveis.
| Capacidad observada | Por qué resulta útil | Cómo habría emergido |
|---|---|---|
| Equilibrio y recuperación | Evita perder la jugada después de un contacto o una caída | La estabilidad permite seguir buscando el gol |
| Carrera y aceleración | Reduce el tiempo para alcanzar el balón o cerrar un espacio | La velocidad mejora la ventaja competitiva |
| Regate y control | Mantiene la pelota cerca mientras el robot cambia de dirección | Controlar la posesión aumenta las opciones de marcar |
| Protección y entrada | Permite conservar o recuperar la pelota frente a un oponente | El rival introduce presión y obliga a defender |
| Pase y coordinación | Distribuye la acción entre varios agentes | En partidos colectivos, cooperar puede superar el juego individual |
O salto difícil: da simulação ao piso real
A física simulada é sempre uma aproximação. Motores, superfícies, câmeras e articulações reais têm tolerâncias, atrasos e ruídos que o modelo virtual não reproduz perfeitamente. Essa diferença é conhecida como sim-to-real gap: uma política brilhante na tela pode falhar assim que toca um tapete ou recebe um empurrão inesperado.
A Skild AI afirma que transferiu a política treinada para o humanoide físico sem retreinamento específico para a tarefa e a colocou à prova tanto contra pessoas quanto contra outros robôs. O vídeo mostra corridas, aproximação da bola, mudanças de direção e recuperação da postura. É uma demonstração impressionante de transferência, embora a empresa não tenha publicado junto com ela um artigo revisado por pares, código reproduzível nem métricas completas de taxa de sucesso.
Por isso, convém separar a evidência visível de uma conclusão geral. O robô executa habilidades físicas aprendidas em simulação; ainda não sabemos com que frequência falha, quanto seu desempenho muda em outra superfície, quão dependente é dessa bola ou como responde após horas de operação.
S1 e a ambição de um cérebro para muitos robôs
O experimento se apoia no S1, o modelo generalista apresentado pela Skild AI para aprender novas tarefas em contexto. A proposta da empresa é que um robô possa observar uma demonstração e adaptá-la sem treinar um modelo separado do zero. Essa abordagem faz parte de uma ambição maior: o Skild Brain, uma base de inteligência física capaz de operar diferentes corpos, desde braços e plataformas móveis até quadrúpedes e humanoides.
A Skild AI foi fundada em Pittsburgh em 2023 por Deepak Pathak e Abhinav Gupta, pesquisadores vinculados ao Robotics Institute da Carnegie Mellon University. A empresa atraiu capital da Lightspeed, Coatue, SoftBank, Jeff Bezos e Felicis Ventures. Aydin Senkut, fundador da Felicis, tem sido um de seus promotores; Ryan Kitchie lidera a expansão comercial global da empresa.
O investimento explica a escala de computação e também obriga a ler com cautela as demonstrações corporativas. Uma boa sequência de vídeo prova que existe uma capacidade, mas não substitui um benchmark independente, documentação de segurança ou resultados sustentados em produção.
O futebol é o laboratório; a indústria é a partida
Uma fábrica, uma obra ou uma cozinha não têm placar, regras fechadas nem reinício instantâneo. Para transferir o autojogo a esses espaços, será necessário construir objetivos que não recompensem atalhos perigosos, simulações suficientemente variadas e limites que protejam pessoas, produtos e maquinário. A autonomia útil precisa aprender e, ao mesmo tempo, saber quando parar.
A partir de Geniales.co e KingNews.online, vemos nesta demonstração uma pista importante para a inteligência incorporada: o avanço não consiste apenas em reconhecer objetos ou conversar, mas em converter percepção, decisão e movimento em um comportamento robusto. O autojogo pode produzir experiência em uma escala impossível para um laboratório físico, desde que essa experiência sobreviva ao contato com o mundo real.
A pergunta já não é unicamente se um robô pode marcar um gol. É se a competição consigo mesmo pode lhe ensinar as habilidades gerais de que necessita depois para carregar, montar, inspecionar ou assistir. A Skild AI mostra uma resposta promissora, ainda parcial e pendente de verificação independente.
O que foi demonstrado e o que ainda falta medir
O caso reúne três avanços: geração autônoma de experiência, surgimento de habilidades não prescritas uma a uma e transferência do simulador para um humanoide. Sua importância está na combinação, não no fato de o robô jogar melhor do que uma pessoa.
Faltam dados públicos sobre arquitetura, recompensa, número de agentes, consumo computacional, hardware, durabilidade e desempenho fora do cenário mostrado. Até que existam testes comparáveis, os 140 anos simulados e a transferência direta devem ser entendidos como resultados comunicados pela Skild AI. São suficientes para abrir uma conversa séria; não para declarar resolvido o aprendizado físico geral.
Enlaces
Receba o KingNews no seu e-mail
Resumo de tecnologia e jogo, sem ruído. Cancele quando quiser.
Quer nos enviar uma notícia?
Conte-nos sua história. Nossa equipe editorial analisa e entra em contato.
Deseja anunciar em nosso meio?
Escreva para nós e enviaremos as opções de anúncio e audiências.
Outras publicações

Software empresarial · IA · Equipos globales
GoldTower.pro frente a chats corporativos y audífonos traductores: 10 ventajas para equipos que hablan idiomas distintos
Arquitectura · Biodiversidad · Ciudades sostenibles
Bee Bricks: el ladrillo que convierte cada muro en un refugio para abejas solitarias
Ciencia ficción · Conciencia · Futuros posibles
¿Y si ya estuvieras viviendo otra vida?
Gamificación · Fidelización · Marketing interactivo
GenerativeGames.online: juegos a medida que convierten clientes ocasionales en una comunidad fiel
Opinión · Automatización · Política fiscal
Que los robots también coticen: por qué la automatización necesita reglas fiscales, no prohibiciones
Economía · Inteligencia artificial · Futuro del trabajo